وقتی صحبت از پیشرفت هوش مصنوعی میشود، معمولاً توجهها به مدلهای بزرگتر، مراکز داده قدرتمندتر و رقابت شرکتهای فناوری برای ساخت نسل بعدی هوش مصنوعی جلب میشود. اما بخش مهم دیگری نیز وجود دارد که کمتر درباره آن صحبت میشود: استنتاج هوش مصنوعی یا AI Inference؛ فرایندی که امکان استفاده عملی از مدلهای آموزشدیده را فراهم میکند.
از تولید پاسخ در چتباتها و خلاصهسازی اسناد گرفته تا پیشنهاد محصولات، تشخیص تقلب و اجرای دستیارهای هوشمند، استنتاج همان مرحلهای است که هوش مصنوعی آموختههای خود را به نتیجهای قابل استفاده تبدیل میکند.
اهمیت این فرایند با گسترش کاربردهای هوش مصنوعی بیشتر شده است. برای شرکتها و استارتاپها، ساخت یک مدل قدرتمند بهتنهایی کافی نیست؛ آنها باید بتوانند خدمات هوش مصنوعی را با سرعت مناسب، هزینه قابل کنترل و قابلیت پاسخگویی به تعداد زیادی کاربر ارائه دهند. در این میان، استنتاج هوش مصنوعی نقشی کلیدی در هزینه، کیفیت و مقیاسپذیری محصولات دارد.
استنتاج هوش مصنوعی چیست؟
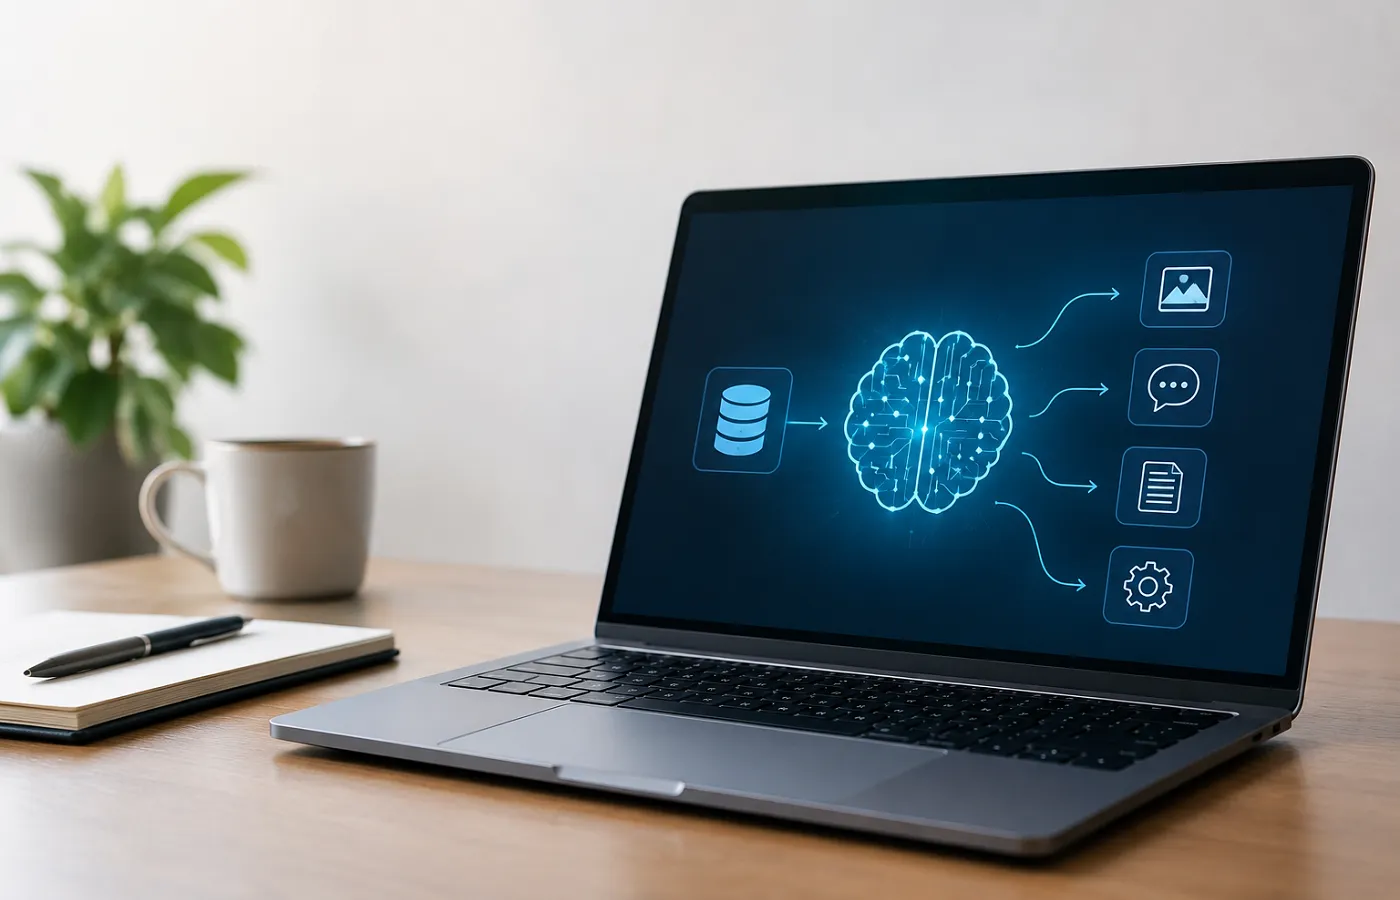
استنتاج هوش مصنوعی فرایندی است که طی آن یک مدل آموزشدیده، اطلاعات جدید را دریافت میکند و بر اساس الگوهایی که قبلاً آموخته است، خروجی تولید میکند، پیشبینی انجام میدهد یا تصمیمی میگیرد.
برای درک سادهتر موضوع، آموزش مدل را مانند یادگیری یک مهارت در نظر بگیرید و استنتاج را مرحلهای بدانید که فرد از آن مهارت برای انجام یک کار واقعی استفاده میکند.
برای مثال، یک چتبات پشتیبانی مشتری را تصور کنید که قبلاً با دادههای فراوان آموزش دیده است. هنگامی که کاربر سؤالی میپرسد، مدل ورودی را پردازش میکند و پاسخی متناسب با آن تولید میکند. این فرایند، استنتاج هوش مصنوعی است.
همین مفهوم در کاربردهای دیگری نیز دیده میشود:
- تولید محتوا: مدل زبانی بر اساس درخواست کاربر، متن یا کد تولید میکند.
- تشخیص تقلب: مدل تراکنش جدید را بررسی میکند و احتمال مشکوک بودن آن را تخمین میزند.
- پیشنهاد محتوا: سامانه بر اساس رفتار کاربران، مطالب یا محصولات مرتبط را پیشنهاد میکند.
- تشخیص هرزنامه: مدل بررسی میکند که یک ایمیل به احتمال زیاد ناخواسته است یا خیر.
طبق توضیحات شرکت IBM، استنتاج زمانی رخ میدهد که مدل آموزشدیده از الگوهای یادگرفتهشده برای پردازش دادههای جدید استفاده میکند. در مدلهای زبانی بزرگ، این فرایند میتواند شامل پیشبینی پیدرپی توکنهای بعدی برای ساخت پاسخ باشد.
تفاوت استنتاج هوش مصنوعی با آموزش مدل چیست؟
آموزش و استنتاج دو مرحله متفاوت از چرخه عمر مدلهای هوش مصنوعی هستند، هرچند ارتباط نزدیکی با یکدیگر دارند.
آموزش هوش مصنوعی (AI Training) مرحلهای است که مدل با استفاده از دادههای آموزشی، الگوها و روابط میان اطلاعات را یاد میگیرد. در بسیاری از مدلهای یادگیری ماشین، پارامترهای مدل بارها تنظیم میشوند تا خطای پیشبینی کاهش یابد یا عملکرد آن به سطح مطلوب برسد. این فرایند ممکن است به دادههای فراوان و توان محاسباتی قابل توجه نیاز داشته باشد.
استنتاج هوش مصنوعی (AI Inference) مرحله استفاده از مدل آموزشدیده است. مدل داده جدید را دریافت میکند و بدون آنکه در هر درخواست لزوماً پارامترهای خود را آموزش دهد، خروجی موردنظر را تولید میکند.
برای مثال، شرکتی ممکن است یک مدل را برای تشخیص پیامهای تبلیغاتی ناخواسته آموزش دهد. آموزش، توانایی تشخیص الگوهای هرزنامه را در مدل ایجاد میکند؛ اما هر بار که ایمیل تازهای دریافت میشود، بررسی آن ایمیل توسط مدل نمونهای از استنتاج است.
| ویژگی | آموزش مدل | استنتاج هوش مصنوعی |
|---|---|---|
| هدف | یادگیری یا تنظیم الگوها | استفاده از الگوهای آموختهشده |
| دادهها | معمولاً مجموعه داده آموزشی | ورودیهای جدید و واقعی |
| خروجی | مدل آموزشدیده یا بهروزشده | پیشبینی، پاسخ یا تصمیم |
| دغدغه اصلی | کیفیت یادگیری و دقت مدل | سرعت، هزینه و توان پاسخگویی |
این تفاوت برای کسبوکارها اهمیت زیادی دارد. ممکن است آموزش یک مدل هزینهبر باشد، اما پس از آماده شدن مدل، هزینه اجرای آن برای هر درخواست نیز باید محاسبه شود. اگر محصولی میلیونها درخواست دریافت کند، مجموع هزینههای استنتاج میتواند به یکی از مهمترین هزینههای عملیاتی آن تبدیل شود.
چرا استنتاج هوش مصنوعی اهمیت بیشتری پیدا کرده است؟
در مراحل اولیه توسعه بسیاری از محصولات هوش مصنوعی، تمرکز اصلی روی آزمایش مدلها و نمایش قابلیتهای آنهاست. اما زمانی که یک ابزار وارد استفاده روزمره میشود، شرایط تغییر میکند.
فرض کنید یک استارتاپ ابتدا یک چتبات را برای چند کارمند داخلی راهاندازی میکند. در این مرحله، تعداد درخواستها محدود است و هزینه پردازش احتمالاً قابل مدیریت خواهد بود. اما اگر همان محصول به هزاران مشتری ارائه شود، تعداد درخواستها افزایش پیدا میکند و زیرساخت باید پاسخگوی بار کاری بسیار بزرگتری باشد.
این مسئله چند پیامد مهم دارد:
۱. افزایش هزینه محاسباتی: هر درخواست به منابع پردازشی نیاز دارد. حتی اگر هزینه یک درخواست پایین باشد، تکرار آن در مقیاس بالا میتواند هزینه قابل توجهی ایجاد کند.
۲. اهمیت سرعت پاسخگویی: کاربران انتظار دارند چتباتها، دستیارهای برنامهنویسی و ابزارهای صوتی در زمان مناسبی پاسخ دهند. تأخیر زیاد میتواند تجربه کاربری را تضعیف کند.
۳. نیاز به زیرساخت مقیاسپذیر: سامانهای که برای ۱۰۰ کاربر مناسب است، ممکن است هنگام ورود همزمان هزاران کاربر با کندی یا اختلال مواجه شود.
۴. ضرورت کنترل هزینه رشد: افزایش تعداد مشتریان همیشه به معنای افزایش سود نیست. اگر هزینه استنتاج سریعتر از درآمد رشد کند، حاشیه سود کسبوکار کاهش پیدا میکند.
در نتیجه، شرکتها باید از همان ابتدای طراحی محصول، هزینه هر درخواست، سرعت پردازش و ظرفیت زیرساخت را در نظر بگیرند؛ نه اینکه این مسائل را تنها پس از رشد تعداد کاربران بررسی کنند.
انواع استنتاج هوش مصنوعی
استنتاج را میتوان بر اساس زمان پردازش و محل اجرای مدل دستهبندی کرد. این دستهبندیها به پرسشهای متفاوتی پاسخ میدهند: آیا خروجی باید فوراً آماده شود؟ آیا میتوان اطلاعات زیادی را یکجا پردازش کرد؟ و آیا مدل باید روی سرور اجرا شود یا روی دستگاه کاربر؟
۱. استنتاج برخط یا بلادرنگ (Online Inference)
در این روش، مدل ورودی را هنگام دریافت پردازش میکند و نتیجه را برای همان درخواست برمیگرداند. چتباتها، ترجمه زنده و برخی سامانههای تشخیص تقلب به این نوع استنتاج نیاز دارند.
مزیت اصلی آن، پاسخگویی سریع است؛ اما حفظ سرعت در زمان افزایش تعداد کاربران میتواند به سختافزار قدرتمندتر و مدیریت دقیقتر منابع نیاز داشته باشد.
۲. استنتاج دستهای (Batch Inference)
در استنتاج دستهای، حجم زیادی از ورودیها بهصورت گروهی پردازش میشوند. این روش زمانی مناسب است که پاسخ فوری ضروری نباشد.
برای نمونه، یک فروشگاه اینترنتی میتواند دادههای فروش روزانه را در پایان شب تحلیل کند یا مجموعه بزرگی از اسناد را برای دستهبندی خودکار به مدل بسپارد.
پردازش گروهی معمولاً استفاده از منابع را بهینهتر میکند و میتواند هزینه هر ورودی را کاهش دهد، اما نتیجه همه درخواستها لزوماً بلافاصله آماده نمیشود.
۳. پردازش دستهای کوچک (Micro-batching)
این روش میان استنتاج برخط و دستهای قرار میگیرد. در آن، چند درخواست در گروههای کوچک پردازش میشوند تا بهرهوری سختافزار افزایش پیدا کند، بدون اینکه تأخیر بیش از حد بالا برود.
در سرویسهای هوش مصنوعی با کاربران همزمان فراوان، این رویکرد میتواند به استفاده مؤثرتر از منابع پردازشی کمک کند.
استنتاج هوش مصنوعی کجا اجرا میشود؟
محل اجرای مدل نیز بر سرعت، هزینه، حریم خصوصی و مدیریت زیرساخت اثر میگذارد.
- رایانش ابری: مدل روی سرورهای مراکز داده اجرا میشود. این روش دسترسی به منابع قدرتمند و افزایش ظرفیت را آسانتر میکند، اما هزینه سرویس، وابستگی به شبکه و ملاحظات انتقال داده باید بررسی شوند.
- زیرساخت داخلی (On-premise): سازمان مدل را روی سختافزار تحت مالکیت یا مدیریت خود اجرا میکند. این روش کنترل بیشتری بر دادهها و محیط پردازش میدهد، اما هزینه خرید تجهیزات، نگهداری و نیروی متخصص را افزایش میدهد.
- رایانش لبهای (Edge): پردازش نزدیک به محل تولید داده، مانند کارخانه یا شبکهای از حسگرها، انجام میشود. این روش برای کاربردهایی که به پاسخ سریع نیاز دارند مفید است.
- پردازش روی دستگاه (On-device): مدل مستقیماً روی گوشی، لپتاپ یا دستگاه کاربر اجرا میشود. در این حالت، برخی دادهها میتوانند بدون ارسال به سرور پردازش شوند؛ بااینحال، اندازه مدل و توان پردازشی دستگاه محدودیت ایجاد میکنند.
هیچیک از این روشها همیشه بهترین انتخاب نیست. IBM نیز تأکید میکند که انتخاب زیرساخت مناسب به نوع کاربرد، حجم پردازش، میزان تأخیر قابل قبول و هزینه موردنظر بستگی دارد.
چگونه میتوان هزینه استنتاج را کاهش داد؟
شرکتهای فناوری در تلاشاند با بهبود سختافزار، نرمافزار و روش اجرای مدلها، استنتاج را سریعتر و کمهزینهتر کنند. کسبوکارها نیز میتوانند با چند تصمیم عملی، بهرهوری سیستم خود را افزایش دهند.
استفاده از مدل متناسب با نیاز: هر کاری به بزرگترین مدل موجود نیاز ندارد. برای دستهبندی ایمیلها یا استخراج اطلاعات مشخص از اسناد، ممکن است مدل کوچکتر و تخصصیتر کافی باشد؛ درحالیکه تحلیل پیچیده یا اجرای وظایف چندمرحلهای به مدل قدرتمندتری نیاز دارد.
بهینهسازی پردازش: روشهایی مانند پردازش دستهای، مدیریت حافظه و بهینهسازی اجرای مدل میتوانند استفاده از سختافزار را بهبود دهند.
انتخاب زیرساخت مناسب: برای بار کاری متغیر، سرویس ابری ممکن است انتخاب مناسبی باشد؛ اما در برخی کاربردهای پرتکرار یا حساس، اجرای داخلی یا روی دستگاه میتواند مزایایی داشته باشد.
اندازهگیری هزینه هر درخواست: شرکت باید هزینه واقعی پردازش را در کنار درآمد حاصل از هر کاربر بررسی کند. این کار به شناسایی قابلیتهای پرهزینه و تصمیمگیری درباره محدودیت استفاده یا انتخاب مدل جایگزین کمک میکند.
استنتاج هوش مصنوعی چه معنایی برای استارتاپهای ایرانی دارد؟
برای استارتاپهای ایرانی، ساخت یک محصول مبتنی بر هوش مصنوعی تنها مسئله انتخاب مدل یا نوشتن کد نیست. هزینه دسترسی به زیرساخت، محدودیتهای پرداخت بینالمللی، کیفیت اتصال شبکه، حفاظت از دادههای کاربران و امکان تأمین منابع پردازشی نیز میتوانند در تصمیمگیری اثرگذار باشند.
به همین دلیل، بهتر است پیش از عرضه عمومی محصول، یک نمونه اولیه ساخته شود و هزینه و سرعت آن در شرایط واقعی اندازهگیری شود. اگر محصول برای خلاصهسازی اسناد طراحی شده است، شاید پردازش دستهای کافی باشد؛ اما اگر قرار است دستیار مکالمهای ارائه دهد، تأخیر پاسخ اهمیت بیشتری خواهد داشت.
همچنین باید مشخص شود چه اطلاعاتی به سرویس خارجی ارسال میشوند و آیا میتوان دادههای حساس را در محیط داخلی یا روی دستگاه پردازش کرد. اجرای محلی لزوماً همیشه ارزانتر نیست، زیرا هزینه سختافزار و نگهداری نیز باید محاسبه شود؛ بااینحال، در برخی کاربردها کنترل بیشتر بر دادهها میتواند ارزشمند باشد.
برای یک استارتاپی که در کشورمان مستقر است، مزیت رقابتی الزاماً در استفاده از بزرگترین مدل یا گرانترین زیرساخت نیست. گاهی انتخاب مدل مناسب، حذف پردازشهای غیرضروری و طراحی دقیق جریان کار، امکان ارائه محصولی اقتصادیتر و پایدارتر را فراهم میکند.
جمعبندی
استنتاج هوش مصنوعی مرحلهای است که مدل آموزشدیده را به ابزاری کاربردی تبدیل میکند. هر بار که یک مدل به پرسش کاربر پاسخ میدهد، سندی را خلاصه میکند یا پیشبینی تازهای انجام میدهد، فرایند استنتاج در حال اجراست.
با گسترش استفاده از هوش مصنوعی، توجه به این مرحله اهمیت بیشتری پیدا میکند؛ زیرا سرعت پاسخگویی، هزینه محاسباتی، مقیاسپذیری و حریم خصوصی همگی به نحوه اجرای مدل وابستهاند.
برای کسبوکارها، بهویژه استارتاپها، پیام اصلی روشن است: ساخت یک مدل قدرتمند با ساخت یک محصول هوش مصنوعی موفق یکسان نیست. محصول موفق باید بتواند قابلیتهای مدل را با هزینهای منطقی، کیفیت مناسب و زیرساختی قابل اتکا به کاربران ارائه دهد. در این مسیر، درک درست استنتاج هوش مصنوعی میتواند به تصمیمگیری بهتر و ساخت کسبوکارهای پایدارتر کمک کند.