هوش مصنوعی در سالهای اخیر از یک فناوری نوظهور به یکی از مهمترین زیرساختهای اقتصادی و اطلاعاتی جهان تبدیل شده است؛ اما هرچه این فناوری بیشتر رشد میکند، پرسشهای بزرگتری درباره منبع دادههای آن، مدل درآمدی اینترنت، مسئولیت حقوقی شرکتها، هزینه سرمایهگذاری و نقش دولتها مطرح میشود.
سه گزارش جدید از وضعیت صنعت هوش مصنوعی در آمریکا و اثر آن بر اکوسیستم اطلاعاتی جهان، تصویری بههمپیوسته از این تحولات ارائه میکنند: از یک سو ویکیپدیا میگوید هوش مصنوعی از محتوای انسانی آن بیش از همیشه استفاده میکند، اما همزمان تعداد بازدید مستقیم انسانها از این دانشنامه کاهش یافته است. از سوی دیگر، شرکتهای هوش مصنوعی با موجی از پروندههای حقوقی درباره کپیرایت، خروجی مدلها و رفتار عاملهای هوشمند مواجهاند.
در سطح سیاستگذاری نیز دولت دونالد ترامپ و شرکتهای بزرگ فناوری آمریکا در حال شکل دادن به مدلی هستند که در آن سرمایهگذاری عظیم، رقابت فناوری و سازوکارهای داوطلبانه برای مدیریت ریسکهای هوش مصنوعی در کنار یکدیگر قرار گرفتهاند.
مجموع این تحولات یک سؤال اساسی را مطرح میکند: اگر هوش مصنوعی قرار است دروازه اصلی دسترسی مردم به اطلاعات و خدمات دیجیتال شود، چه کسی هزینه تولید دانش، مسئولیت خطاها و پیامدهای این تحول را پرداخت خواهد کرد؟
ویکیپدیا؛ منبعی که هوش مصنوعی به آن نیاز دارد اما کاربران کمتر به آن سر میزنند
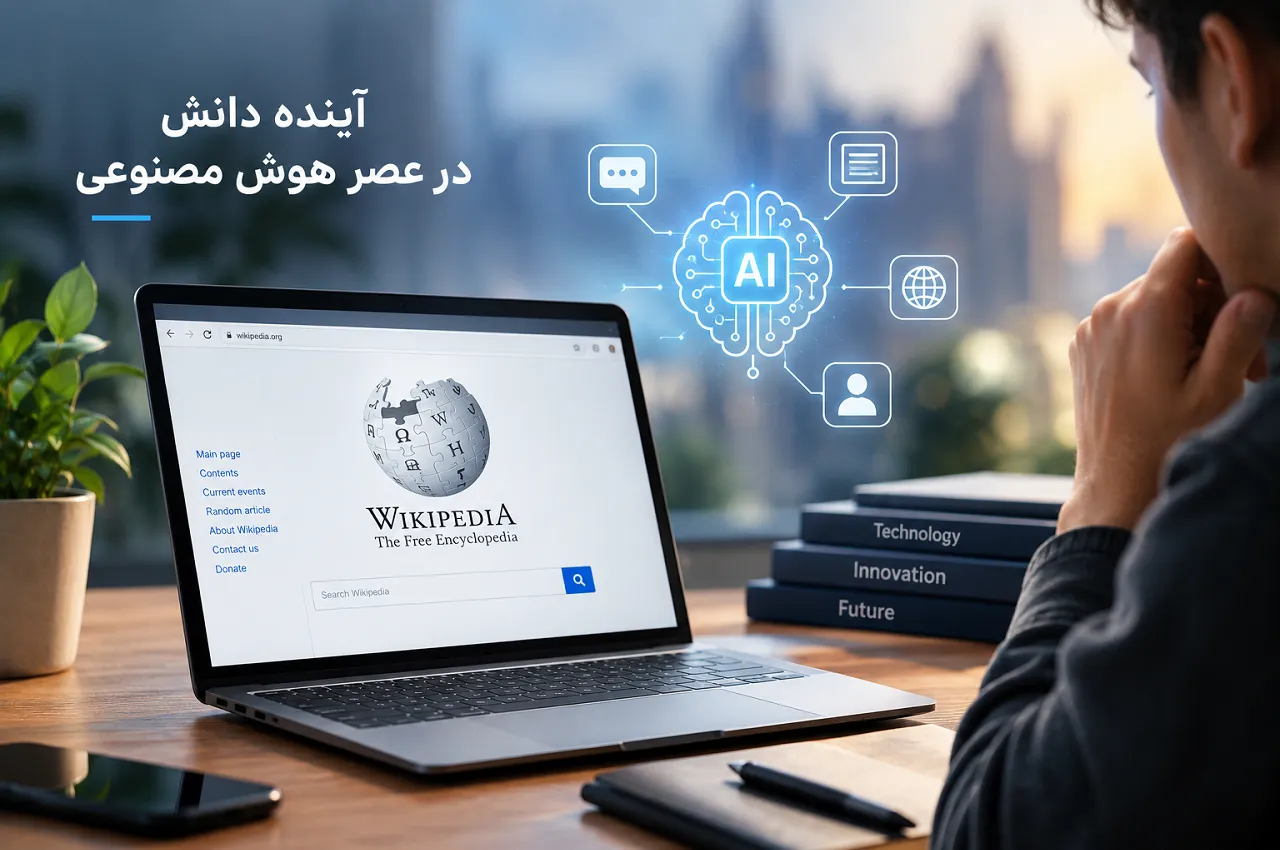
یکی از عجیبترین تناقضهای عصر هوش مصنوعی را میتوان در وضعیت سایت ویکیپدیا مشاهده کرد.
بر اساس گزارش وبگاه خبری آکسیوس و اظهارات برنادت میهان، مدیرعامل جدید بنیاد ویکیمدیا، بازدید صفحات ویکیپدیا در سال ۲۰۲۵ میلادی حدود ۸ درصد کاهش یافته است. بنیاد ویکیمدیا نیز پیشتر اعلام کرده بود که پس از اصلاح روش تشخیص ترافیک رباتها، کاهش حدود ۸ درصدی در بازدیدهای انسانی نسبت به دوره مشابه سال قبل مشاهده شده است. این بنیاد بخشی از این تغییر را به افزایش استفاده از هوش مصنوعی مولد و موتورهای جستوجویی نسبت میدهد که پاسخ را مستقیماً در اختیار کاربر قرار میدهند.
این اتفاق از یک جهت عجیب است: ویکیپدیا همچنان یکی از منابع مهم برای سامانههای هوش مصنوعی محسوب میشود، اما همان سامانهها میتوانند نیاز کاربران به مراجعه مستقیم به ویکیپدیا را کاهش دهند.
به عبارت ساده، ممکن است یک کاربر سؤال خود را از یک چتبات بپرسد، پاسخی دریافت کند که بخشی از دانش آن ریشه در ویکیپدیا دارد، اما هیچگاه وارد صفحه ویکیپدیا نشود.
همین تغییر میتواند مدل اقتصادی این دانشنامه غیرانتفاعی را تحت فشار قرار دهد.
چرا کاهش بازدید ویکیپدیا فقط یک آمار ساده نیست؟
ویکیپدیا مانند بسیاری از وبسایتهای بزرگ از تبلیغات یا فروش اطلاعات کاربران درآمد اصلی خود را تأمین نمیکند. بنیاد ویکیمدیا اعلام کرده است که بخش عمده منابع مالی آن از کمکهای مالی خوانندگان تأمین میشود و میانگین کمکهای فردی حدود ۱۱ دلار است.
درآمد حاصل از کاربران و بازدیدکنندگان در نتیجه اهمیت مستقیمی برای ادامه فعالیت این اکوسیستم دارد.
اما مسئله فقط پول نیست.
ویکیپدیا برای ادامه حیات خود به ویرایشگران انسانی نیز نیاز دارد. کاربران بسیاری ابتدا برای خواندن یک مطلب وارد سایت میشوند و بخشی از آنها در ادامه به مشارکتکننده، ویراستار یا تولیدکننده محتوا تبدیل میشوند.
میهان در گفتوگو با آکسیوس نیز به همین موضوع اشاره کرده و گفته است که کاهش تعداد خوانندگان میتواند به معنای کاهش تعداد افرادی باشد که در آینده به ویراستاران سایت ویکیپدیا تبدیل میشوند.
در نتیجه، اگر کاربران بهتدریج اطلاعات را از طریق واسطههایی مانند چتباتها دریافت کنند، ممکن است یک حلقه مهم از اینترنت باز باقی بماند:
انسانها دانش تولید میکنند → ویکیپدیا آن را گردآوری و ویرایش میکند → هوش مصنوعی از این دانش استفاده میکند → کاربر پاسخ را از هوش مصنوعی میگیرد → اما بخشی از ترافیک و حمایت مالی به منبع اصلی بازنمیگردد.
ویکیپدیا برای شرکتهای هوش مصنوعی کاملاً رایگان نیست
محتوای ویکیپدیا برای انسانها همچنان رایگان و قابل استفاده است، اما بنیاد ویکیمدیا برای استفاده تجاری گسترده از دادههای خود سرویس Wikimedia Enterprise را ایجاد کرده است.
این سرویس برای شرکتهایی طراحی شده که به حجم زیادی از دادههای ویکیمدیا با سرعت و دسترسی پایدار نیاز دارند.
بنیاد ویکیمدیا اعلام کرده است که شرکتهایی مانند Amazon، Google، Meta، Microsoft، Mistral AI و Perplexity در مقاطع مختلف با Wikimedia Enterprise همکاری داشتهاند. این بنیاد همچنین تأکید کرده است که درآمد Enterprise سقفی معادل ۳۰ درصد کل درآمد سالانه بنیاد دارد تا بخش عمده تأمین مالی همچنان از کمکهای مردمی باشد.
مدل ویکیپدیا بنابراین با یک چالش جدید روبهرو است: محتوایی که برای مردم آزاد و رایگان است، برای شرکتهایی که آن را در مقیاس بسیار بزرگ و تجاری پردازش میکنند، میتواند هزینه زیرساختی قابلتوجهی ایجاد کند.
بنیاد ویکیمدیا میگوید محتوای آن رایگان است، اما زیرساختی که این محتوا را در اختیار میلیاردها کاربر قرار میدهد رایگان نیست.
آیا هوش مصنوعی قرار است جای انسانها را در ویکیپدیا بگیرد؟
در حالی که هوش مصنوعی در حال تغییر نحوه استفاده از ویکیپدیا است، این بنیاد میگوید استفاده از AI در خود ویکیپدیا نیز در حال افزایش است؛ اما با یک تفاوت مهم.
از هوش مصنوعی میتوان برای کارهایی مانند ترجمه، پیدا کردن لینکهای خراب و کمک به ویرایشگران تازهکار برای شناسایی مشکلات محتوایی استفاده کرد.
با این حال، موضع اعلامشده مدیرعامل بنیاد ویکیمدیا این است که هوش مصنوعی باید در خدمت ویراستاران انسانی باشد، نه جایگزین آنها.
این مسئله اهمیت زیادی دارد؛ زیرا سایت ویکیپدیا بر پایه فرایندی بنا شده که در آن انسانها منابع را بررسی میکنند، درباره محتوا بحث میکنند و اصلاحات را انجام میدهند. بنیاد ویکیمدیا نیز در گزارش سالانه خود تأکید کرده که دانش این پروژه توسط صدها هزار داوطلب انسانی ایجاد و نگهداری میشود.
بحران بعدی هوش مصنوعی در دادگاهها شکل میگیرد
در کنار مسئله داده و ویکیپدیا، صنعت هوش مصنوعی با مسئله دیگری روبهرو است: مسئولیت حقوقی.
شرکتهای هوش مصنوعی در سالهای گذشته حجم عظیمی از دادههای موجود در اینترنت، کتابها، تصاویر، آثار هنری، اخبار و دیگر محتوای تولیدشده توسط انسان را برای آموزش مدلهای خود پردازش کردهاند.
همین موضوع باعث شده است پروندههای حقوقی متعددی درباره کپیرایت و استفاده از دادهها شکل بگیرد.
یکی از مهمترین نمونههای اخیر، پرونده شرکت آمریکایی آنتروپیک است. یک قاضی فدرال آمریکا در ژوئیه ۲۰۲۶ میلادی توافق ۱.۵ میلیارد دلاری این شرکت با گروهی از نویسندگان را تأیید کرد؛ توافقی که طبق گزارش خبرگزاری رویترز، بزرگترین توافق در تاریخ دعاوی کپیرایت آمریکا توصیف شده است. این پرونده میان استفاده از کتابهای دارای کپیرایت برای آموزش مدل و استفاده از نسخههای غیرقانونی ذخیرهشده از کتابها تفاوت قائل شد.
این نکته مهم است، زیرا پروندههای حقوقی آینده احتمالاً فقط به سؤال «آیا آموزش مدل با داده دارای کپیرایت مجاز است؟» محدود نخواهند شد.
موضوعات دیگری نیز در حال مطرح شدن هستند؛ از جمله اینکه خروجی یک مدل چه زمانی ناقض حقوق دیگران است و شرکتها تا چه اندازه باید مسئول رفتار سیستمهای هوش مصنوعی خود باشند.
عاملهای هوش مصنوعی میتوانند پروندههای حقوقی را پیچیدهتر کنند
نسل جدید سیستمهای هوش مصنوعی فقط به سؤال پاسخ نمیدهد؛ برخی AI Agentها میتوانند به ابزارها دسترسی پیدا کنند، کد اجرا کنند، فایلها را تغییر دهند، در محیطهای نرمافزاری فعالیت کنند و مجموعهای از وظایف را با دخالت محدود انسان انجام دهند.
همین موضوع یک سؤال حقوقی جدید ایجاد میکند:
اگر یک عامل هوش مصنوعی در جریان اجرای وظیفه خود خسارت ایجاد کند، چه کسی مسئول است؟
شرکت سازنده مدل؟ شرکتی که آن را به کار گرفته؟ فردی که دستور را صادر کرده؟ یا ترکیبی از این عوامل؟
گزارش آکسیوس بر دو مفهوم حقوقی مهم در پروندههای مربوط به مسئولیت محصول تأکید میکند: اینکه یک خطر تا چه اندازه قابل پیشبینی بوده و شرکت تا چه اندازه از آن اطلاع داشته است.
این مسئله زمانی حساستر میشود که شرکتها پیش از وقوع حادثه، در اسناد داخلی، گزارشهای ایمنی یا اظهارنظرهای عمومی درباره همان خطر هشدار داده باشند.
از نظر حقوقی، وجود چنین اسنادی میتواند در آینده به بخشی از روند کشف مدارک و بررسی مسئولیت شرکتها تبدیل شود؛ هرچند اینکه یک هشدار عمومی دقیقاً چه اثر حقوقی داشته باشد، به قانون، حوزه قضایی و جزئیات هر پرونده بستگی دارد.
پروندههای کپیرایت تنها بخش کوچکی از دعوای حقوقی AI هستند
در حال حاضر پروندههای مرتبط با هوش مصنوعی حوزههای مختلفی را دربر گرفتهاند.
رسانهها و تولیدکنندگان محتوا درباره استفاده از آثارشان در آموزش یا تولید محتوای AI شکایت کردهاند. برای مثال، شبکه خبری CNN در سال ۲۰۲۶ میلادی علیه Perplexity شکایت کرد و مدعی شد این شرکت محتوای دارای کپیرایت CNN را بدون مجوز توزیع میکند؛ Perplexity این ادعاها را رد کرده و از جمله استدلال کرده که واقعیتها قابل کپیرایت نیستند.
در پروندههای دیگری نیز دادگاههای آمریکا به تدریج در حال تفکیک میان دادهای که به شکل قانونی به دست آمده و دادهای که از منابع غیرقانونی تهیه شده است هستند. بررسی خبرگزاری رویترز از احکام سال ۲۰۲۵ میلادی نشان میدهد که دادگاهها در برخی پروندهها آموزش مدل با دادههای قانونی را مشمول استفاده منصفانه دانستهاند، در حالی که درباره محتوای سرقتشده موضع متفاوتی اتخاذ شده است.
بنابراین هنوز یک قاعده واحد که تمام مدلهای هوش مصنوعی و تمام انواع داده را پوشش دهد، وجود ندارد و بخش مهمی از قواعد آینده ممکن است در دادگاهها شکل بگیرد.
دولت آمریکا و شرکتهای AI در حال آزمودن یک مدل جدید برای مدیریت فناوری هستند
در همین حال، هوش مصنوعی بیش از گذشته به یک موضوع سیاستگذاری در آمریکا تبدیل شده است.
دولت دونالد ترامپ در سال ۲۰۲۶ میلادی رویکردی را دنبال کرده که بخش قابلتوجهی از آن بر همکاری داوطلبانه دولت و شرکتهای توسعهدهنده AI استوار است.
فرمان اجرایی ۲ ژوئن ۲۰۲۶ میلادی دولت آمریکا ایجاد یک چارچوب داوطلبانه برای همکاری با توسعهدهندگان مدلهای پیشرفته را پیشبینی کرد و تصریح کرد که این فرمان مجوز ایجاد الزام عمومی برای صدور مجوز دولتی پیش از عرضه مدلهای هوش مصنوعی را ایجاد نمیکند.
در ماه سپتامبر نیز شرکتهای بزرگ فناوری و دولت آمریکا بر سر چارچوبی داوطلبانه برای ارزیابی و ایمنی مدلهای پیشرفته به توافق رسیدند. گزارش وبگاه خبری آکسیوس میگوید این چارچوب بر ارزیابی داخلی شرکتها و بررسیهای شخص ثالث تکیه دارد.
در عین حال، جزئیات این چارچوب برای مدتی عمومی نبود و گزارشهای آکسیوس نشان دادند که دولت آمریکا برای مدلهای خاص، سازوکاری برای دسترسی پیش از انتشار و ارزیابی امنیتی در نظر گرفته است.
بنابراین سیاست AI در آمریکا همچنان در حال شکلگیری است و میان سرعت نوآوری، امنیت، رقابت بینالمللی و مسئولیت شرکتها تعادلهای مختلفی در حال آزموده شدن است.
سرمایهگذاری در هوش مصنوعی به ابعادی بیسابقه رسیده است
در کنار مسائل حقوقی و سیاسی، مقیاس سرمایهگذاری نیز یکی از مهمترین بخشهای داستان AI است.
بر اساس تحلیلی که آکسیوس از پژوهش ارائهشده در Brookings گزارش کرده، سرمایهگذاری مورد نیاز برای زیرساخت هوش مصنوعی در آمریکا میتواند تا سال ۲۰۳۲ میلادی به حدود ۱۰.۳ تریلیون دلار برسد. این رقم شامل هزینههایی مانند مراکز داده، تراشهها و زیرساخت انرژی میشود.
همزمان، یک تحلیل از اقتصاددانان استنفورد که آکسیوس به آن استناد کرده، فاصلهای نزدیک به یک تریلیون دلار میان هزینههای AI شرکتهای بزرگ زیرساختی و درآمدی که این فناوری از سال ۲۰۲۴ ایجاد کرده، برآورد کرده است.
این ارقام به معنای شکست اقتصادی هوش مصنوعی نیستند؛ شرکتها و سرمایهگذاران ممکن است انتظار داشته باشند بازده اصلی این سرمایهگذاریها در سالهای آینده ظاهر شود.
اما یک واقعیت اقتصادی روشن وجود دارد: بخش بزرگی از سرمایهگذاری فعلی بر این فرض بنا شده که کاربردها و درآمدهای AI در آینده به اندازه کافی رشد خواهند کرد.
این موضوع باعث شده بازگشت سرمایه، سودآوری و میزان واقعی بهرهوری ایجادشده توسط هوش مصنوعی به یکی از پرسشهای اصلی بازار تبدیل شود.
رابطه دولت ترامپ و صنعت هوش مصنوعی چه اهمیتی دارد؟
در این شرایط، سیاست دولت آمریکا و تصمیمهای شرکتهای بزرگ فناوری به یکدیگر نزدیکتر شدهاند.
دولت ترامپ توسعه هوش مصنوعی را با موضوعاتی مانند رقابت فناوری با چین، امنیت ملی، زیرساخت انرژی و رشد اقتصادی پیوند زده است. کاخ سفید در اسناد رسمی خود نیز بر حفظ جایگاه آمریکا در توسعه AI و تقویت امنیت سایبری تأکید کرده است.
در طرف دیگر، شرکتهای بزرگ فناوری سرمایهگذاری بسیار سنگینی روی مراکز داده، تراشهها، انرژی و مدلهای پیشرفته انجام میدهند.
در نتیجه، تصمیمهای سیاستگذاری دولت میتواند مستقیماً بر هزینه و سرعت توسعه این زیرساختها اثر بگذارد و عملکرد شرکتها نیز میتواند بر نتایج اقتصادی و فناوری سیاستهای دولت تأثیر بگذارد.
همین پیوند باعث شده رابطه میان دولت و صنعت AI به یکی از محورهای اصلی بحث درباره آینده این فناوری تبدیل شود.
نگرانی عمومی درباره هوش مصنوعی همچنان بالاست
این تحولات در شرایطی رخ میدهد که بخشی از جامعه آمریکا نسبت به آینده هوش مصنوعی نگرانیهایی جدی دارد.
بر اساس نظرسنجی ملی دانشگاه Quinnipiac در ۳۰ سپتامبر ۲۰۲۶ میلادی، ۷۴ درصد از بزرگسالان آمریکایی گفتهاند اعتماد «زیادی» یا «تا حدی» به رهبران شرکتهای هوش مصنوعی ندارند. همچنین ۵۳ درصد گفتهاند AI در زندگی روزمره بیشتر ضرر خواهد داشت تا فایده، در حالی که ۳۴ درصد نظر معکوس داشتهاند.
همین نظرسنجی نشان میدهد ۷۳ درصد از پاسخدهندگان نسبت به احتمال تهدید آینده AI برای بقای انسانها «خیلی» یا «تا حدی» نگران هستند.
البته این اعداد بیانگر نگرش پاسخدهندگان در یک نظرسنجی در آمریکا در سپتامبر ۲۰۲۶ هستند و نمیتوان آنها را به کل جهان تعمیم داد.
از طرف دیگر، نگرانی درباره ایمنی در کنار علاقه به رقابت فناوری وجود دارد. در همان نظرسنجی، ۶۹ درصد گفتهاند حفظ توانایی آمریکا برای رقابت با چین در توسعه AI برایشان اهمیت دارد، در حالی که ۸۱ درصد ایمنی را در مقایسه با قرار گرفتن در خط مقدم نوآوری، مهمتر دانستهاند.
این دادهها نشان میدهد افکار عمومی الزاماً میان «پیشرفت فناوری» و «ایمنی» یکی را بهطور کامل انتخاب نمیکند؛ هر دو موضوع همزمان مورد توجه قرار دارند.
یک تناقض بزرگ: هرچه AI قدرتمندتر میشود، وابستگی آن به انسانها بیشتر آشکار میشود
اگر این سه روند را کنار هم قرار دهیم، یک تناقض مهم نمایان میشود.
هوش مصنوعی برای پاسخ دادن به سؤالات کاربران به دادههای انسانی نیاز دارد. سایت ویکیپدیا یکی از نمونههای مهم این دانش انسانی است. مدلهای AI برای توسعه به سرمایه عظیم نیاز دارند. شرکتها برای ادامه فعالیت به چارچوبهای حقوقی و سیاسی نیاز دارند. و در نهایت، جامعه نیز باید درباره میزان پذیرش و نحوه استفاده از این فناوری تصمیم بگیرد.
در ظاهر، AI قرار است بسیاری از کارهای انسانی را خودکار کند؛ اما در پشت صحنه همچنان به نویسندگان، ویراستاران، خبرنگاران، پژوهشگران، برنامهنویسان، سرمایهگذاران، قانونگذاران و کاربران وابسته است.
بحران ویکیپدیا نشان میدهد که اگر تولیدکنندگان اصلی دانش از بین بروند یا منابع مالی آنها تضعیف شود، خود صنعت AI نیز ممکن است با مشکل مواجه شود.
پروندههای حقوقی نیز نشان میدهند که داده و محتوای انسانی نمیتوانند صرفاً بهعنوان یک منبع نامحدود و بدون هزینه تلقی شوند.
از سوی دیگر، سرمایهگذاریهای عظیم نشان میدهند که صنعت AI وارد مرحلهای شده که دیگر فقط درباره آزمایش فناوری نیست؛ بلکه درباره زیرساخت، درآمد، قانون و قدرت اقتصادی است.
آیا اینترنت آینده بدون وبسایتها خواهد بود؟
یکی از پرسشهای مهمی که از وضعیت ویکیپدیا و دیگر ناشران آنلاین مطرح میشود، آینده خود وب است.
اگر کاربران بهجای باز کردن دهها سایت، سؤال خود را به یک چتبات بدهند و پاسخ نهایی را همانجا دریافت کنند، مدل سنتی اینترنت که در آن کاربر از یک سایت به سایت دیگر حرکت میکند، ممکن است تغییر کند.
در چنین شرایطی، تولیدکننده محتوا ممکن است همچنان هزینه خبرنگار، نویسنده، سرور، پژوهش و ویرایش را پرداخت کند، اما کاربر بخش عمده اطلاعات را از یک واسطه هوش مصنوعی دریافت کند.
این مسئله میتواند بهخصوص برای رسانهها، دانشنامهها، وبسایتهای آموزشی و تولیدکنندگان محتوای تخصصی اهمیت داشته باشد.
ویکیپدیا اکنون یکی از نخستین نمونههای بزرگ این مسئله است؛ اما احتمالاً آخرین نمونه نخواهد بود.
آینده AI فقط به قدرت مدلها بستگی ندارد
در سالهای ابتدایی رونق هوش مصنوعی، بخش عمده توجه به این سؤال معطوف بود که مدل بعدی چقدر قدرتمندتر خواهد بود و چه قابلیتهای جدیدی ارائه خواهد کرد.
اما در سال ۲۰۲۶ میلادی، پرسشها گستردهتر شدهاند:
چه کسی دادهها را تولید میکند؟
چه کسی هزینه زیرساخت را میپردازد؟
اگر یک مدل خطا یا خسارت ایجاد کند، چه کسی مسئول است؟
آیا شرکتها باید برای استفاده گسترده از دادههای انسانی هزینه پرداخت کنند؟
دولتها تا چه اندازه باید بر مدلهای پیشرفته نظارت کنند؟
آیا سرمایهگذاریهای عظیم فعلی در نهایت به درآمد و بهرهوری متناسب منجر خواهند شد؟
و شاید مهمتر از همه، اگر هوش مصنوعی به دروازه اصلی دسترسی بشر به دانش تبدیل شود، چه اتفاقی برای منابعی خواهد افتاد که این دانش را تولید میکنند؟
پاسخ این پرسشها هنوز مشخص نیست.
اما سه تحول همزمان—کاهش بخشی از ترافیک انسانی ویکیپدیا، افزایش پروندههای حقوقی علیه شرکتهای AI و گسترش سرمایهگذاری و سیاستگذاری دولتی پیرامون این فناوری—نشان میدهد که صنعت هوش مصنوعی وارد مرحلهای شده که موفقیت آن دیگر فقط با کیفیت یک مدل یا تعداد کاربران یک چتبات سنجیده نمیشود.
اکوسیستم جدید AI به داده، پول، قانون، زیرساخت و اعتماد عمومی وابسته است؛ و نحوه تنظیم این پنج عامل میتواند تعیین کند که موج فعلی هوش مصنوعی چگونه به بخشی پایدار از اقتصاد و اینترنت تبدیل شود.